ChatGPT Sites で Web アプリお試し
- 10 分で読めます - 4652 文字ChatGPT Sites を使うと、静的な Web ページだけでなく、API と DB を持つ Web アプリも Codex から公開できました。
今回作成したのは、従業員の打刻と管理者の勤怠確認・承認を扱う kintain という PoC です。
私が確かめたかったのは、Sites でどこまで手軽に公開できるのか、作成したアプリはどこで動くのか、そして静的サイト以外も扱えるのかという 3 点でした。 そのため、既存アプリの移行ではなく、最初から Sites で公開する前提で Codex に制作を任せています。
この記事では、制作から公開までの流れと実行環境を紹介します。 この機能は同日時点でパブリックベータのため、利用条件や対応範囲は今後変わる可能性があります。
ChatGPT Sites で確かめたかったのは、手軽さ・実行環境・静的サイトの先の 3 点
一般的な Web アプリでは、画面を作るだけで公開は終わりません。 サーバーの実行環境、DB、環境変数、公開 URL、デプロイ手順を用意し、それぞれが正しく接続されているか確認する必要があります。
公式ドキュメントでは、Web サイトや Web アプリを作成し、ホストして共有するところまでを Codex から扱えると説明されています。 そこで今回は、次の 3 点を実物で確認することにしました。
- アプリの制作から公開 URL を得るまで、どれだけ手作業を減らせるか
- 公開した HTML、API、DB がどのような構成で動くか
- ログインやデータ更新を伴う Web アプリも公開できるか
題材にした kintain では、従業員がスマートフォンから出勤・退勤を記録し、勤務実績の修正や休暇・欠勤を申請できます。
管理者は PC から勤務状況と予定を確認し、実績の修正、申請の承認・却下、監査ログの確認を行います。
メールアドレスとパスワードによる認証、従業員と管理者のロール判定、ログインセッションもアプリ内に実装しました。 画面を配信するだけでは成立しないため、Sites が静的サイトの先まで扱えるかを確かめる題材になります。
Sites スキルに任せると、公開を前提にした構成まで Codex が組み立てた
Codex には、Sites スキルを使って公開する前提で勤怠管理 PoC を作るよう依頼しました。 要件を伝えた後は、画面と API の実装だけでなく、Worker 互換の実行環境に合わせた構成、DB の関連付け、Sites のホスティング設定まで Codex が進めました。
私は自分の Cloudflare アカウントで Worker や D1 を作成せず、一般的な CI/CD の設定も用意していません。 主に行ったのは、実装内容とプレビューを確認し、保存した Version を公開するか判断することでした。
Sites とローカルプロジェクトの関連付けは、.openai/hosting.json に保存されています。
このファイルを見ると、DB のバインディング名が DB、ファイル保存用の R2 が未使用であることが分かります。
{
  "project_id": "...",
  "d1": "DB",
  "r2": null
}
ここでいうバインディングは、実行中のアプリから外部リソースを参照するための接続口です。
アプリは DB という名前を通じて、Sites に関連付けられた DB を利用します。
手軽だったのは、実装と公開基盤の間を自分でつなぐ作業が少なかった点です。 ただし、Codex が生成した構成をそのまま信用すればよいという意味ではありません。 後述する PBKDF2 のように、ローカルでは見えなかった実行環境の制約を調べ、用途に応じた判断が必要になる場面もありました。
Version を保存して確認してから、公開 URL へデプロイする
公開は、Version の保存とデプロイという 2 段階に分かれています。
Version はソースとビルド結果を結び付けた公開候補で、保存した段階ではプレビューを確認できます。
その後、公開する Version を選んでデプロイすると、chatgpt.site ドメインの本番 URL が発行されます。
公式ドキュメントでは、デプロイで得られる URL はすべて本番 URL とされています。 内容を確認するだけなら、まず Version を保存し、プレビューで動作を確かめるのが安全です。
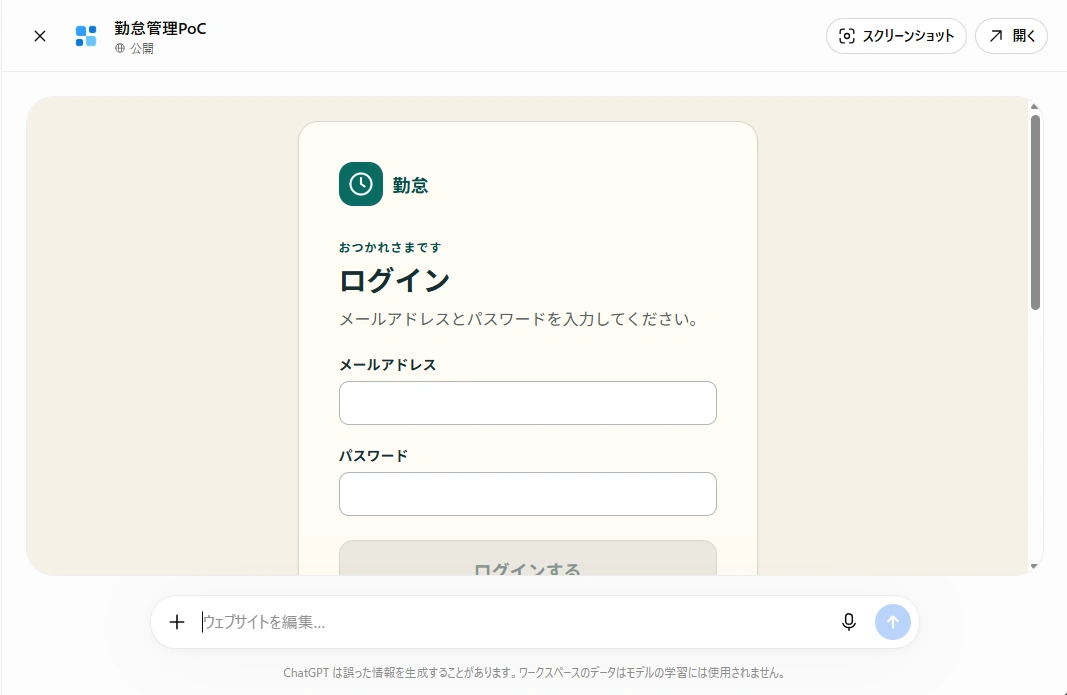
注: 執筆時点では、WebUI 上から Version の操作はできない模様
今回は Codex が、Version を保存し、筆者がプレビューを確認してから公開しました。 GitHub Actions のワークフローを書いたり、別のホスティングサービスへ成果物を送ったりする工程はありません。
この流れは、公開を完全に自動化するものではありません。 どの Version を外部へ公開するかは人が決めるため、Codex に制作を任せながら公開直前の確認を残せます。
公開先は、静的ファイル・Worker 互換サーバー・D1 をまとめて扱う Sites の環境
公開した PoC は、ChatGPT Sites が管理するホスティング環境で動いています。
利用者は chatgpt.site の URL へアクセスし、同じ Vinext(フレームワーク名) アプリから静的ファイルとサーバー処理を利用します。
実際の構成は次のとおりです。
flowchart TD
    Browser["スマートフォン・PC ブラウザ"]
    Sites["ChatGPT Sites<br/>chatgpt.site ドメイン"]
    Assets["静的ファイル・PWA<br/>HTML / JavaScript / CSS / Service Worker"]
    Server["Vinext サーバー・API<br/>Worker 互換の実行環境"]
    D1["Cloudflare D1<br/>バインディング名: DB"]

    Browser -->|HTTPS| Sites
    Sites --> Assets
    Sites --> Server
    Server --> D1
フロントエンドと API を別々のサーバーへ配置した構成ではありません。
wrangler.jsonc では、Vinext の fetch handler がサーバー処理の入口に指定され、ビルド済みの静的ファイルは ASSETS バインディングから参照されます。
{
  "main": "vinext/server/fetch-handler",
  "assets": {
    "directory": "dist/client",
    "binding": "ASSETS"
  }
}
つまり、この PoC については「ChatGPT Sites 上の Worker 互換アプリと D1」という構成で捉えるのが実態に近いです。 VPS、コンテナ基盤、独立した API サーバー、R2 は使用していません。
注: ChatGPT Sites の物理的な基盤について、OpenAI から詳しい公式発表があったわけではありません。本稿の「Worker 互換」は、リポジトリの設定と公開環境で確認した API の挙動を指します。
D1 に勤怠情報とセッションを保存し、API から読み書きする
DB には、SQLite の SQL セマンティクスを備えたサーバーレスデータベースである Cloudflare D1 を使っています。
kintain では、従業員、現場、勤務予定、勤務実績、打刻履歴、申請、監査ログ、ログインセッションを D1 に保存します。
アプリの getDatabase() は、Worker 互換の環境から DB バインディングを取り出します。
ログイン API は、その DB から利用者を検索し、パスワードを照合した後にセッションを保存します。
import { env } from "cloudflare:workers";

export type DatabaseBindings = Pick<Env, "DB">;

export function getDatabase(bindings: DatabaseBindings = env): D1Database {
  return bindings.DB;
}
後続のリクエストでは、Cookie のトークンをハッシュ化し、D1 の sessions テーブルを検索して利用者とロールを判定します。
この処理は D1AuthRepository で確認できます。
ブラウザへ静的ファイルを配信した後、すべての処理をクライアント側だけで済ませているわけではありません。 API が認証と権限を確認し、D1 へデータを読み書きするため、状態を持つ Web アプリとして動いています。
公開環境で、従業員画面・管理者画面・セッションを確認できた
実際に従業員としてログインすると、その日の現場、予定時刻、出退勤の状態が表示されました。 再読み込みしてもログイン状態は維持され、ログアウトするとログイン画面へ戻りました。
次の画面では、スマートフォン向けの打刻画面で、現場と勤務予定を確認できます。
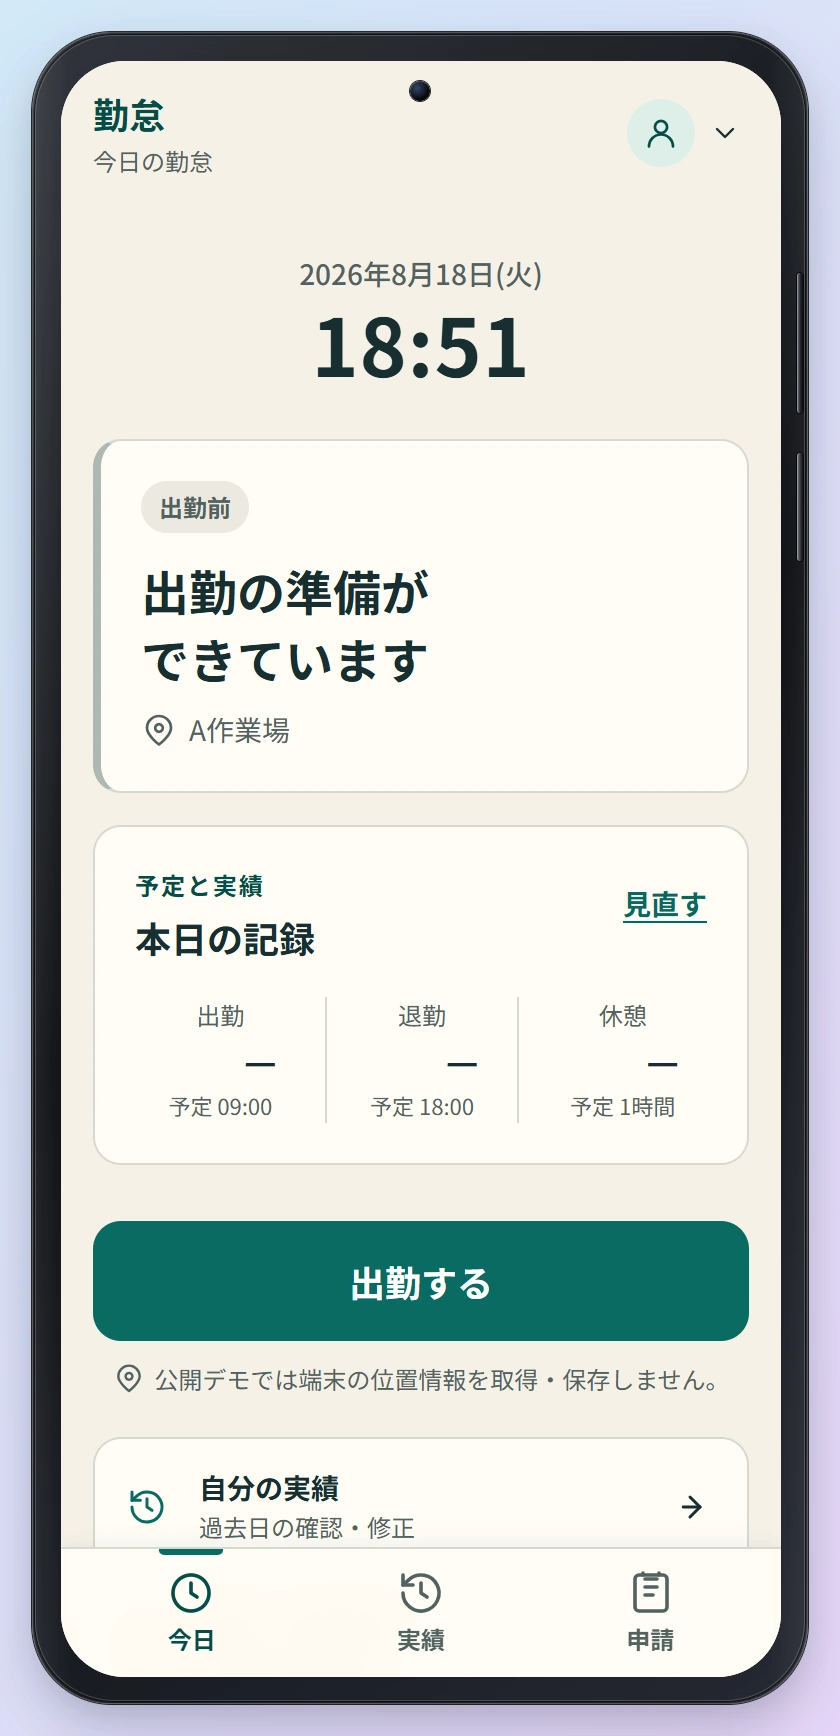
現場と予定時刻がログインした従業員に合わせて表示されるため、公開 URL から認証後のデータを取得できていることを確認できます。
管理者としてログインすると、当日の一覧に 5 人の従業員、配属先、予定時刻、勤務状態が表示されました。 監査ログ画面では、勤務予定の作成、申請、デモデータのリセット、勤務実績の修正を含む 21 件の記録を確認できました。
次の画面では、管理者が複数の従業員の勤務状況を一覧で確認できることが分かります。
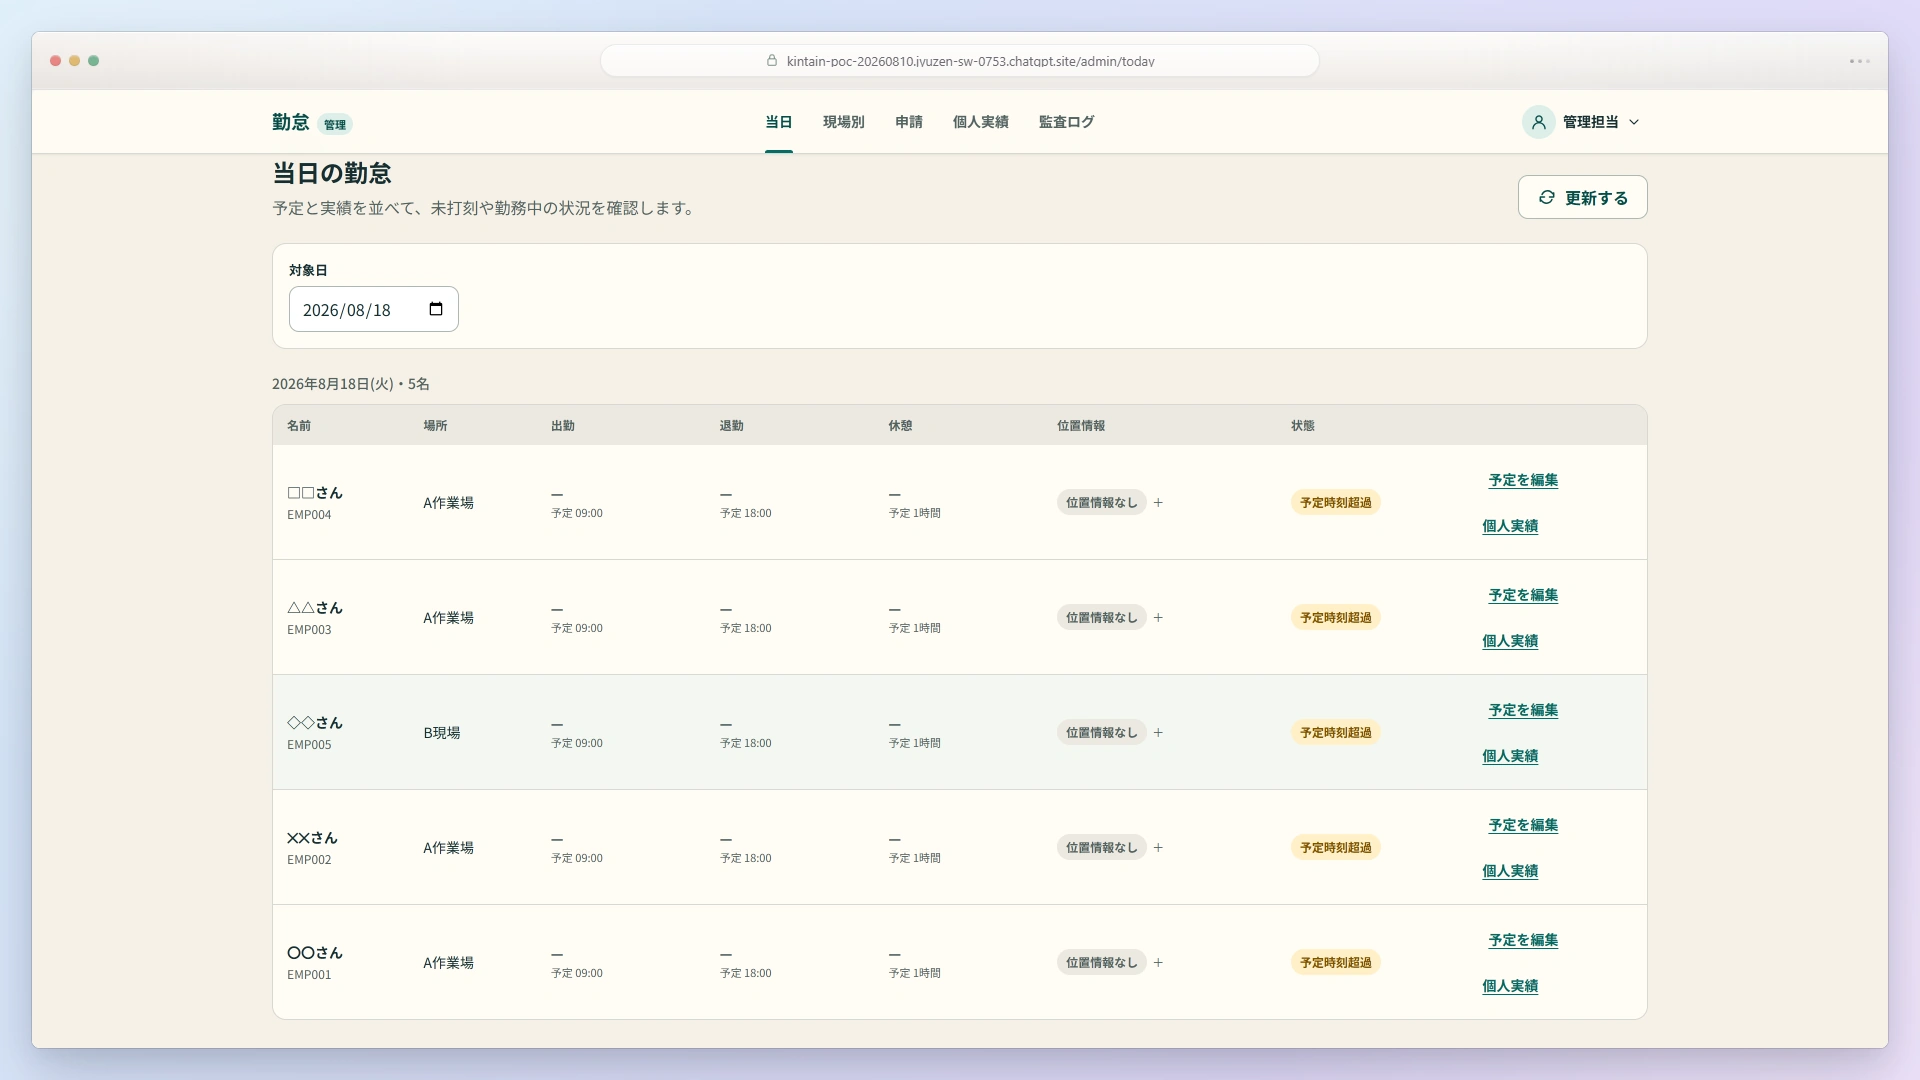
従業員画面と同じ公開 URL の配下でも、ログインした利用者のロールに応じて管理機能を分けられています。
この確認だけで D1 の内部状態を直接観測したわけではありません。
しかし、公開画面で認証後のデータ取得とセッション維持を確認し、リポジトリでは同じ処理が DB バインディングを通じて D1 を読み書きしていることを確認しています。
画面上の観測とソースコードの両方から、公開版が静的ファイルだけで完結していないと判断できます。
PBKDF2 の反復回数は、公開環境の上限に合わせる必要があった
制作中に最も分かりやすく実行環境の違いが表れたのは、パスワードをハッシュ化する PBKDF2 の反復回数でした。
kintain の通常設定は 60 万回ですが、その設定で公開すると、ログイン時の鍵導出を実行できませんでした。
調査すると、当時参照した workerd の PBKDF2 実装 では、DoS を避けるため反復回数が最大 10 万回に制限されていました。
10 万回を超える値は DOMNotSupportedError として拒否されます。
この結果を受けて、通常モードの 60 万回は維持し、公開デモモードだけを 10 万回に分けました。
demo-mode.ts では、DEMO_MODE、ALLOW_PUBLIC_DEMO、SHOW_DEMO_CREDENTIALS の 3 つがすべて有効な場合だけ、公開デモ用の設定が成立します。
この変更は、10 万回を本番用パスワードの推奨値と判断したものではありません。
公開デモはダミーの従業員情報と公開用認証情報だけを扱い、実在する利用者の認証情報を保存しないという条件で範囲を限定しています。
判断の経緯と制約は 0002-sites-public-demo-password-cost.md に残しました。
この問題から、Sites が公開作業を手軽にしても、実行環境の互換性まで自動的に保証されるわけではないと分かります。 暗号 API や実行時間の上限に依存する処理は、公開環境でも確認する必要があります。
公開は手軽でも、データとセキュリティの判断は利用者に残る
Sites には公開範囲を選ぶ仕組みがありますが、今回の PoC は誰でもアクセスできる公開デモとしてデプロイしています。 そこで、Sites の公開範囲と、アプリ内の従業員・管理者ロールを別のものとして扱いました。
公開 URL へアクセスできることは、管理者機能を使えることを意味しません。 アプリ側でメールアドレスとパスワードを照合し、D1 に保存したセッションとロールを API ごとに確認しています。 更新処理には CSRF 対策を入れ、ログインの失敗回数もアカウントと IP アドレスの単位で制限しています。
一方、この実装をそのまま実在する従業員向けの本番システムとして使うことは想定していません。 勤怠情報は個人情報を含み、認証、権限、保存期間、監査、障害対応などを組織の要件に合わせて設計する必要があります。
Sites の手軽さが減らすのは、主にアプリを公開環境へつなぐまでの作業です。 何を公開してよいか、ランタイムの制約をどう受け入れるか、本番運用に必要な要件を満たすかという判断は残ります。
まとめ
- ChatGPT Sites では、Codex に制作を任せ、Version の保存、プレビュー、デプロイまでを一つの流れで進められました。
kintainは、静的ファイルに加えて Worker 互換のサーバー処理と D1 を使い、API、独自認証、セッション、監査ログを動かしています。- 公開先は
chatgpt.siteの URL を持つ ChatGPT Sites の管理環境で、GitHub Pages や別に用意した API サーバーではありません。 - PBKDF2 の反復回数上限のように、ローカルと公開環境の違いへ個別に対応する場面はあります。
- 公開作業が手軽になっても、扱うデータ、認証強度、本番運用の可否は開発者が判断する必要があります。
今回の結果から、ChatGPT Sites は静的な紹介ページを素早く公開する用途だけに閉じた機能ではないと分かりました。 今回の PoC では、DB 付き Web アプリを作り、公開環境で動作を確かめるところまでを Codex とのやり取りの中で完結できました。
参考
- リポジトリ
- ChatGPT Sites 上の PoC
- ChatGPT Sites 公式ドキュメント
- Cloudflare D1 公式ドキュメント
- Cloudflare Workers Static Assets